
Риччи Рич
· Промоушен ·
ИИ-агенты и автоматизация процессов,которые освобождают время команды
ИИ-агенты
Как измерить эффект ИИ-агента: снять пять показателей до запуска и те же пять через 1–2 недели пилота. Это время первого ответа клиенту, доля обращений без человека, часы сотрудника на рутину, доля заявок с полными данными в CRM и ошибки с передачами в журнале. Эффект — это разница двух замеров.
Пять показателей, таблица «как мерить и где брать данные», замер за четыре шага. Плюс что эффектом не считать.
Для кого: собственник, маркетолог или руководитель продаж, который запускает или уже запустил ИИ-агента и хочет понять, окупается ли он, а не верить на слово.
Что внутри: пять показателей, таблица замера, четыре шага «до/после», список ложных эффектов, как считаем по журналу у себя и мини-проверка готовности.
Чтение — 8–9 минут
Измерить эффект ИИ-агента можно одним способом: снять пять показателей до запуска и те же пять через две-четыре недели пилота. Разница между двумя замерами и есть эффект. Отчёт платформы с числом диалогов, восторг менеджера или его же раздражение к эффекту отношения не имеют.
Почему именно сравнение? Потому что у агента нет «правильного» значения, которое можно взять из чужой статьи. Время первого ответа в салоне красоты и на оптовой базе стройматериалов отличается в разы, и оба варианта могут быть нормой. Единственная честная точка отсчёта для вашей компании: вы же сами месяц назад.
Отсюда главное требование: замер «до» снимают до того, как агент написал первое сообщение. Если пилот уже идёт, а цифр «до» нет, их придётся восстанавливать по старым перепискам и CRM. Это возможно, но дольше и менее точно. Проще заложить день на замер в план пилота, о котором мы писали в статье «4 ИИ-пилота за 70 000 ₽».
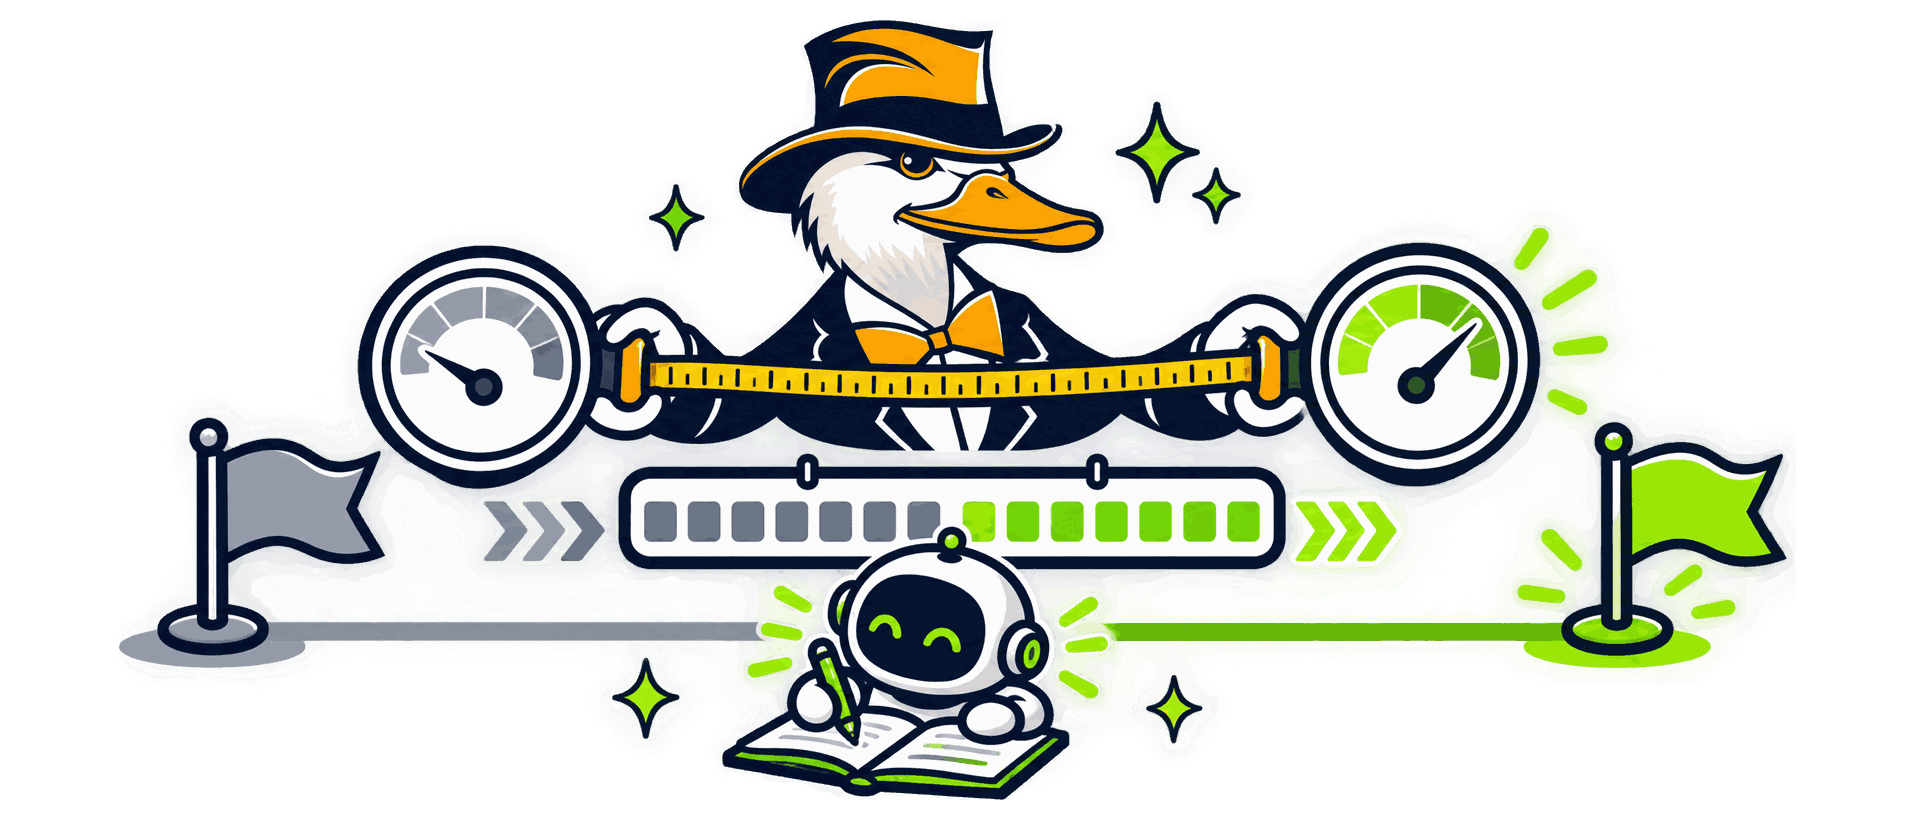
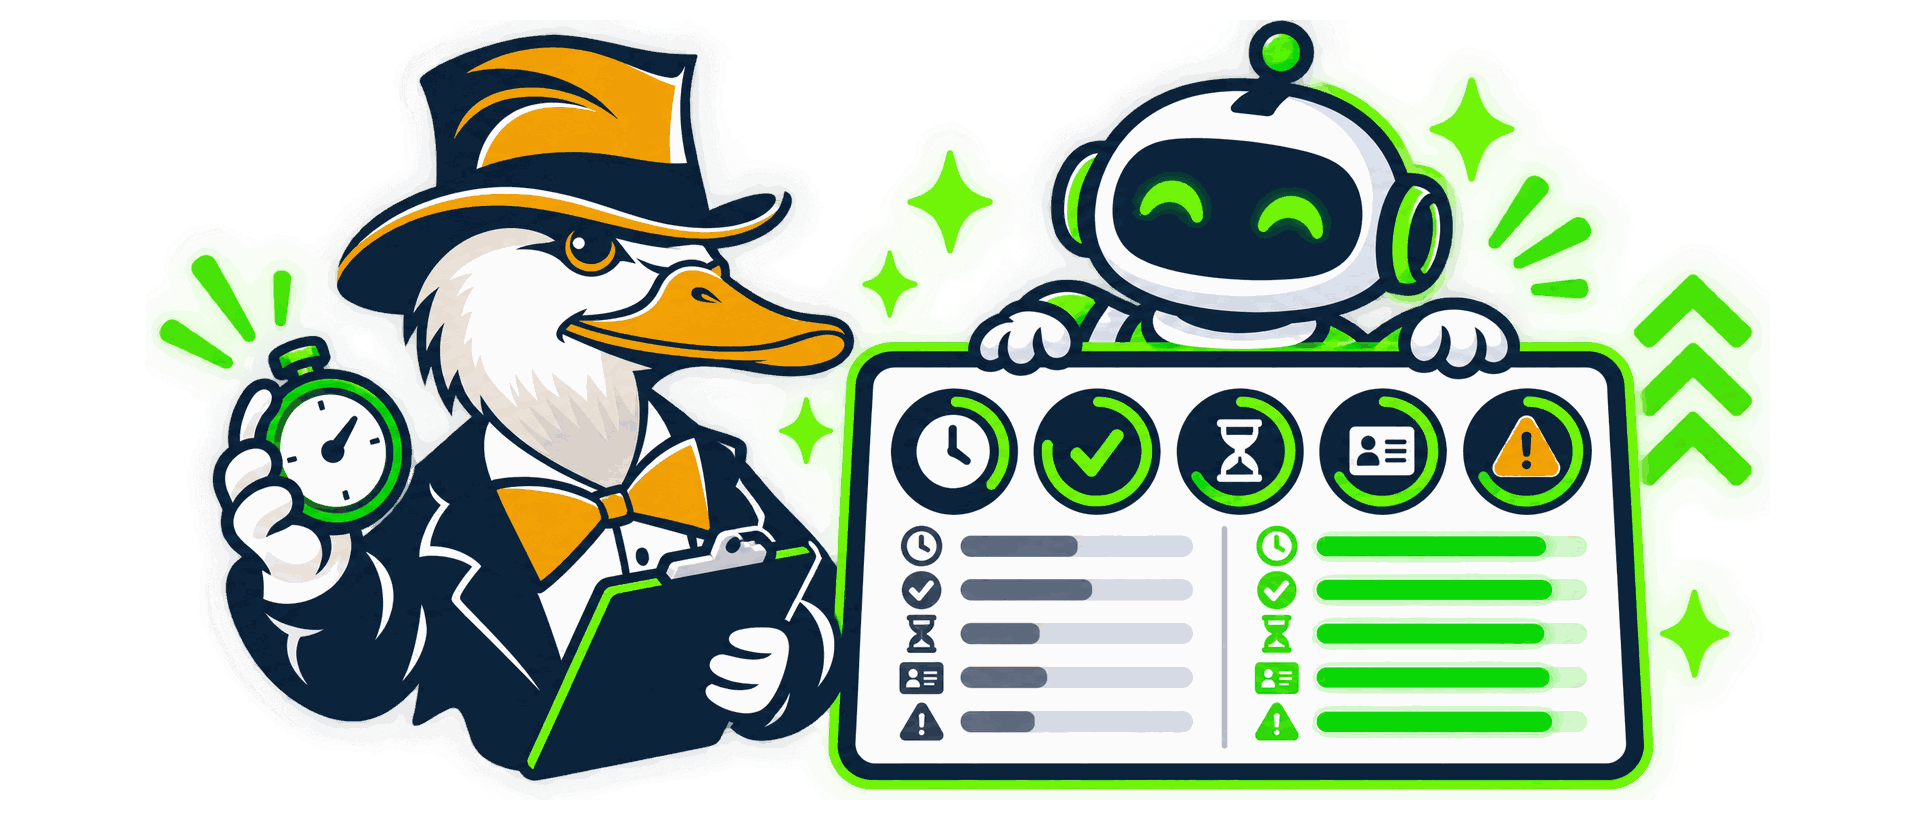
Пользу ИИ-агента проверяют по пяти показателям: время первого ответа клиенту, доля обращений без участия человека, часы сотрудника на рутину, доля заявок с полными данными в CRM и число ошибок с передачами человеку. Набор один и тот же для агента продаж, сервиса и записи, меняется только то, что считать «обращением».
Сколько проходит от сообщения клиента до первого содержательного ответа. Дежурное «здравствуйте, ожидайте» в счёт не идёт, нужен ответ по делу. Считают медиану, а не среднее: одна заявка, провисевшая выходные, не должна портить картину.
Какая часть диалогов дошла до результата (ответ получен, запись сделана, заявка оформлена) без вмешательства менеджера. Здесь легко обмануться: диалог, который клиент бросил на полуслове, закрытым не считается.
Сколько часов в неделю менеджер тратит на то, что отдали агенту: ответы на одинаковые вопросы, перенос заявок в CRM, напоминания. Единственный из пяти показатель, который снимают хронометражем, а не из системы.
Какая часть сделок попала в CRM со всеми обязательными полями: имя, контакт, запрос, источник. Пустое поле означает, что менеджер потом переспрашивает клиента, а это снова время и часть потерянных заявок.
Сколько раз за неделю агент ответил неверно, не нашёл ответ в базе или по регламенту передал диалог менеджеру. Ошибки и штатные передачи считают отдельно: вторые не беда, пока их доля не растёт.
Показатели 2 и 5 держат друг друга в рамках. Если агент закрывает почти всё сам, а передач ноль, стоит проверить, не отвечает ли он там, где должен молчать. Границы, за которыми агент обязан позвать человека, записаны в регламенте ИИ-агента, а журнал показывает, соблюдаются ли они.
Все пять показателей снимают из систем, которые у компании уже есть: мессенджер, CRM, журнал агента и хронометраж сотрудника. Отдельная аналитика для первого замера не нужна. Хватит таблицы с пятью строками и двумя колонками: «до» и «после».
| Показатель | Как мерить | Где взять данные | Что считать нормой |
|---|---|---|---|
| Время первого ответа | Медиана за неделю по всем новым обращениям, в минутах. Рабочие и нерабочие часы считать отдельно | История переписки в мессенджере, отчёт CRM по времени реакции | Сравнить с замером «до». Хорошо, если стало меньше |
| Доля обращений без человека | Диалоги с результатом без вмешательства менеджера, делённые на все диалоги за неделю | Журнал агента, метки «передано человеку» в CRM | Сравнить с замером «до» (до запуска она равна нулю). Хорошо, если растёт без роста ошибок |
| Часы на рутину | Хронометраж 3–5 рабочих дней: сотрудник отмечает, сколько ушло на ответы, перенос заявок и напоминания | Таблица хронометража, короткий опрос сотрудника | Сравнить с замером «до». Хорошо, если меньше, и видно, куда ушло освободившееся время |
| Заявки с полными данными | Сделки с заполненными обязательными полями, делённые на все новые сделки за неделю | Отчёт CRM по пустым полям, выборочная проверка 20 карточек | Сравнить с замером «до». Хорошо, если больше |
| Ошибки и передачи | Подсчёт по журналу за неделю: неверные ответы, «не знаю», передачи по регламенту | Журнал действий агента, жалобы клиентов, разбор менеджером | До запуска показателя нет. Сравнивать неделю с неделей внутри пилота. Хорошо, если ошибки снижаются, а передачи стабильны |
← Таблицу можно листать вбок →
Для четвёртого показателя агенту нужен доступ к CRM, и здесь полезно заранее решить, что он делает сам, а что готовит на подтверждение. Варианты полномочий разобраны в статье про доступы ИИ-агента к CRM. Если агент только готовит карточку, а заносит её человек, показатель всё равно считают: полнота данных растёт за счёт того, что агент дособрал их в диалоге.
Замер проводят в четыре шага: фиксируют показатели до запуска, запускают агента на части обращений, через две-четыре недели снимают те же показатели тем же способом и сравнивают. Главные слова здесь «тем же способом»: если «до» считали по CRM, а «после» по ощущениям менеджера, сравнивать нечего.
Выберите одну неделю до запуска, обычную, без праздников и акций. Снимите четыре показателя (пятого ещё нет) и запишите в таблицу вместе с датами и способом подсчёта. Хронометраж рутины сотрудник ведёт сам.
Агент берёт один канал или один тип вопросов, остальное идёт по-старому. Так на одном отрезке времени у вас есть и «с агентом», и «без», а сезонность действует на обе группы одинаково.
Через две недели сделайте первый замер, через четыре второй. Первая неделя пилота обычно шумная: базу знаний правят, регламент уточняют. Поэтому за эффект берут последнюю неделю пилота, а не первую.
Положите две колонки рядом. По нашему опыту, если три показателя из пяти сдвинулись в нужную сторону, а ошибки не растут, агента расширяют. Если сдвинулся один или ни одного, разбирают журнал: чаще виновата база знаний, а не сама идея.
Можно ли сократить срок? Для показателей 1 и 4 хватит недели, они меняются быстро. Доля закрытых без человека и часы рутины требуют хотя бы двух недель: в первую сотрудник ещё перепроверяет за агентом, и его время не освобождается.
Эффектом не считают лайки и реакции, количество диалогов, ощущение «стало легче» и число сообщений, которые отправил агент. Все эти величины растут сами по себе, как только агент включён, и ничего не говорят о заявках и времени команды.
Клиент поставил сердечко на ответ бота. Приятно, но заявка от этого в CRM не появилась. Реакции говорят о вежливости агента, а не о его пользе.
Агент провёл за неделю триста диалогов. Сколько из них дошло до результата? Без ответа на этот вопрос число диалогов измеряет нагрузку, а не эффект. Иногда рост диалогов означает, что клиенты переспрашивают.
Менеджер говорит, что дышать стало свободнее. Полезный сигнал для разговора с командой, но не замер. Проверьте его хронометражем: если часы на рутину не изменились, легче стало по другой причине.
Длинные, подробные, с тремя уточнениями. Платформа показывает их как активность. Клиенту же нужен один точный ответ, и чем он короче, тем лучше для первого показателя.
Соблазн посчитать, сколько менеджеров можно не нанимать. Пока освободившиеся часы не ушли в звонки и сделки, это перераспределение, экономии пока нет. Считайте часы, а не ставки.
Общее правило: показатель годится, если он мог бы ухудшиться. Лайки, диалоги и сообщения после запуска агента ухудшиться не могут, значит, и их рост ничего не доказывает.
В «Риччи Рич Промоушен» ИИ-агент готовит публикацию для блога и соцсетей, человек подтверждает её в Telegram, и каждое действие агента попадает в журнал. По этому журналу мы и считаем эффект, без отдельной аналитики.
Схема простая. Агент собирает черновик, сверяет факты с базой и отправляет в Telegram карточку: что подготовлено, что изменилось, что требует решения. Человек нажимает «подтвердить» или возвращает на доработку с комментарием. Опубликовать сам агент не может, так записано в его регламенте.
Журнал хранит время каждого шага: когда агент взял задачу, когда отдал на подтверждение, сколько ждал ответа, вернули ли на доработку и почему. Из этих записей складываются наши версии тех же пяти показателей. Время до готового черновика вместо времени ответа клиенту. Доля публикаций, прошедших с первого подтверждения, вместо доли закрытых диалогов. Часы редактора на правку вместо часов на рутину. Полнота карточки (заголовок, описание, картинки, ссылки) вместо полноты заявки в CRM. Возвраты на доработку вместо ошибок.
Что нам это дало в цифрах, здесь не напишу: они зависят от объёма и тематики, и чужие числа вам не помогут. Напишу, что дал сам журнал: спор «агент стал лучше или хуже» закончился в день, когда появилась таблица возвратов по неделям. Такой же журнал мы закладываем в агентов продаж у клиентов, а выбрать первую роль для агента помогает карта первого ИИ-агента.
Отметьте, что у вас уже есть. Чем больше пунктов, тем честнее получится замер.
Хотите понять, какие показатели снять первыми? Напишите, что отметили, — подскажем, с чего начать замер.
Восстановите «до» по истории переписки и CRM за обычную неделю перед запуском: время первого ответа и полноту заявок там видно. Часы на рутину сотрудник оценит по памяти, пометьте эту цифру как приблизительную. Сравнение получится грубее, но лучше, чем ничего.
Те же пять показателей: время первого ответа, доля обращений без человека, часы сотрудника на рутину, доля заявок с полными данными в CRM и ошибки в журнале. Не ставьте KPI на число диалогов или сообщений: они растут сами и ничего не доказывают.
Первые сдвиги по времени ответа и полноте заявок видны через неделю. Долю закрытых без человека и часы рутины надёжно считать через 1–2 недели, когда базу знаний уже поправили и сотрудник перестал перепроверять каждый ответ.
Через часы и заявки. Освободившиеся часы сотрудника умножьте на стоимость его часа, прибавьте заявки, которые раньше терялись из-за долгого ответа и пустых полей, и сравните со стоимостью пилота и поддержки. Цифры берите из своего замера, а не из чужих статей.
Открыть журнал и посмотреть, на чём агент спотыкается. Чаще всего не хватает базы знаний или регламент не описывает частые ситуации. Правят базу, уточняют границы и дают пилоту ещё одну-две недели.
Для первого замера нет. Хватит истории мессенджера, отчёта CRM, журнала агента и таблицы хронометража. Отдельные панели имеет смысл собирать, когда агент работает на нескольких каналах.
Принцип тот же, меняются названия. Время до готового результата вместо времени ответа, доля задач без возврата на доработку вместо доли закрытых диалогов, часы сотрудника на правку, полнота результата и число возвратов. Так мы считаем у себя агента, который готовит публикации.
Передача по регламенту означает, что агент правильно распознал ситуацию, которую должен решать человек: скидку, жалобу, нестандартный запрос. Ошибка — это неверный ответ или ответ там, где агент должен был промолчать. Считают их отдельно.
Один человек, не тот, кто настраивает агента. Руководитель продаж или маркетолог. Он снимает оба замера одним способом и записывает, как именно считал, чтобы через месяц цифры можно было сравнить.
Пять показателей до запуска и те же пять через месяц заменяют любой спор о том, помогает агент или мешает. Таблица с двумя колонками убеждает лучше презентации.
Замер «до» занимает один день. Пропустите его, и через месяц придётся верить на слово агенту и платформе.
Расскажите, какую задачу хотите отдать агенту и где сейчас теряется время. Подскажем, какие показатели снять до старта.
Ещё не выбрали, с какой роли начать? Посмотрите карту первого ИИ-агента.
 Обсудить
 Кирилл Риччи
 WhatsApp
 MAX
 VK
 Дзен
 YouTube
 OK